Reggia
记忆由人策展,Agent 按需读取。
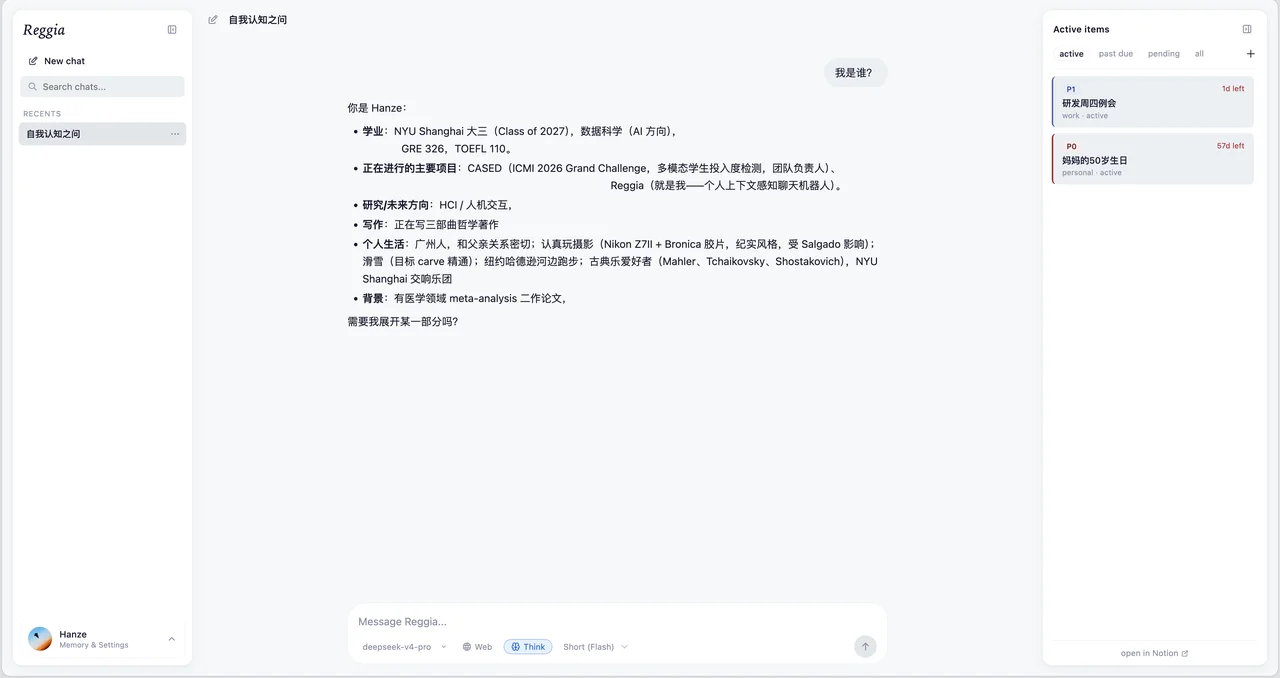
一个个人 AI 入口。长期背景与当前事项由用户自己维护;Agent 只在需要时读取,并且说得出读了什么。它反转了 AI memory 的方向:由人,而不是模型,决定什么是信号。
- 角色
- 独立完成:产品定义与开发编排
- 周期
- 2026.05 – 今
- 形态
- 本地运行的 Web 应用,单用户
- 技术
- FastAPI · 原生 JavaScript · SQLite · Notion API
- 状态
- 日常自用,开源
- 链接
- GitHub
- 先查约 100 tokens 的目录,再决定要不要读 5K 至 30K tokens 的全文
- 2级读取
- ReAct 循环的上限。复杂度停在能被读懂的地方
- 8轮
- 向量库与嵌入管线。没有 AI 替用户决定什么重要
- 0
- 从问题定义到可运行的原型
- 1次冲刺
01问题Problem
模型看见一段对话,人活在一段连续的情境里。
通用聊天产品从对话里猜测什么值得记住,把稳定的背景、当前的任务和偶然的一句话混在同一层。另一条主流路径是向量检索式 RAG:把资料切片、嵌入,再按相似度召回。它的问题不在效果,而在召回过程对用户不可见,也不可干预。用户不知道 Agent 读到了什么,更无法撤回。
Reggia 选择相反的方向:结构由用户亲手策展,Agent 按领域、优先级与敏感级别按需读取。读取路径必须可以解释。
| 比较项 | 模型自动记忆 | 向量检索式 RAG | Reggia |
|---|---|---|---|
| 谁决定记什么 | 模型,从对话里挖掘 | 相似度,从切片里召回 | 用户,写下来并随时修改 |
| 用户看得见吗 | 大多看不见 | 看不见召回了哪些切片 | 看得见。存储是人能读、能改的页面与事项 |
| 代价 | 稳定背景与临时状态混在一层 | 不可控,不可解释 | 要先花力气写下「什么重要」 |
02定义Definition
先路由,再索引,最后才读全文。
长期记忆按工作、研究、思想与个人四个域组织;短期记忆是一组带状态、优先级与敏感级别的进行事项。两者硬分层,也都是两级读取:先用低成本的目录判断相关性,再只取回答真正需要的内容。结构化的 context 不是越多越好,而是让每一次读取都有理由。
事项面板:增删改
最多 8 轮
未知工具直接拒绝
| 记忆 | L1 · 索引 | L2 · 详情 |
|---|---|---|
| 长期背景 | 四个域的章节标题目录,约 100 tokens | 一个域的完整页面,5K 至 30K tokens。每轮最多读一个域 |
| 当前事项 | 事项列表,通常约 200 tokens | 单个事项的备注与细节 |
03编排Agent loop
产品规则,直接写成 Agent 读的规则。
Agent 是一个最多八轮的轻量 ReAct 循环:推理,选工具,读观察结果,再决定继续还是回答。没有额外的编排框架。状态转移直接表现为 SSE 事件,所以界面能区分推理、行动、观察与最终回答,而不是只显示一个旋转的图标。最初的引擎是在容器里编排 Claude Code 子进程,文件系统只读隔离;后来换成进程内的轻量循环,旧引擎保留为可选项。
# Sensitivity
- agent-readable: use freely
- contextual: reasoning only, never surface
  in third-party output
- private: skip entirely

# Updating
Never silently mutate. Propose changes
explicitly and call append/update endpoints
only after {name} confirms.

Available tools: {tool_list}.
Always prefer L1 over L2.TOOL_EXECUTORS = {
"reggia_index": _exec_reggia_index,
"reggia_longterm_index": _exec_reggia_longterm_index,
"reggia_longterm_read": _exec_reggia_longterm_read,
"reggia_items_list": _exec_reggia_items_list,
"reggia_item_detail": _exec_reggia_item_detail,
"web_search": _exec_web_search,
}
executor = TOOL_EXECUTORS.get(name)
if executor:
result = await executor(**args)
else:
result = json.dumps(
{"error": f"unknown tool: {name}"})真实实现节选,有删节。敏感级别、写入前必须确认、读取的成本顺序,这三条都是产品决定;它们以模型能执行的方式写下来,而不是只写在文档里。
04边界Fit
说清楚它不适合谁。
适合
- 对自己的方向与优先级已经有清楚判断的人
- 希望模型带着个人背景工作,但不想让它挖掘自己的对话
- 更信任人能读、能改的存储,而不是不透明的向量
- 愿意先写下什么重要,换取之后的完全控制
不适合
- 想要零维护的记忆
- 需要团队共享的上下文。Reggia 是单用户的
- 希望 AI 帮自己找回已经忘掉的线索
05结果与回顾Outcome
控制权正确,不代表策展体验已经正确。
Reggia 已经是我自己每天使用的 AI 入口。它验证了一个更克制的假设:准确性与用户信任度,不只来自更强的模型,也来自用户能维护、检查并撤回的 context。
回顾:主动维护 context 的摩擦比预期高。「写下什么重要」对多数人仍然是高门槛的动作。下一版会加入策展引导:Agent 可以提问、归纳并提出修改建议,但不能静默写入。控制权的归属不变,上手的路径可以更缓。